

Программа сверки документов на базе ИИ: пример для подбора кандидатов из базы резюме
- Задача
- Автоматизировать процессы обработки документов и создать систему, которая сможет находить наиболее подходящие соответствия среди тысяч документов без ручного анализа.
Во многих компаниях нужно искать соответствия между документами: открытые вакансии и резюме соискателей, проектные задания и архив реализованных проектов, обращения клиентов и база готовых решений, отчеты и связанные материалы или другие.
Когда объем данных становится большим, ручной поиск начинает занимать слишком много времени.
Поиск по ключевым словам не всегда помогает: одинаковый смысл может быть описан разными формулировками. Поэтому недостаточно искать совпадения по отдельным словам — системе нужно понимать содержание документов и определять, насколько они близки друг другу по смыслу.
Решение — ИИ-модуль для сопоставления документов
Сделали систему, которая автоматически подбирает подходящие документы по смыслу и показывает наиболее релевантные результаты.
Семантический поиск вместо поиска по ключевым словам
Решение относится к классу задач семантического сопоставления документов и интеллектуального поиска информации. В основе решения лежат технологии обработки естественного языка (NLP) и машинного обучения (ML).
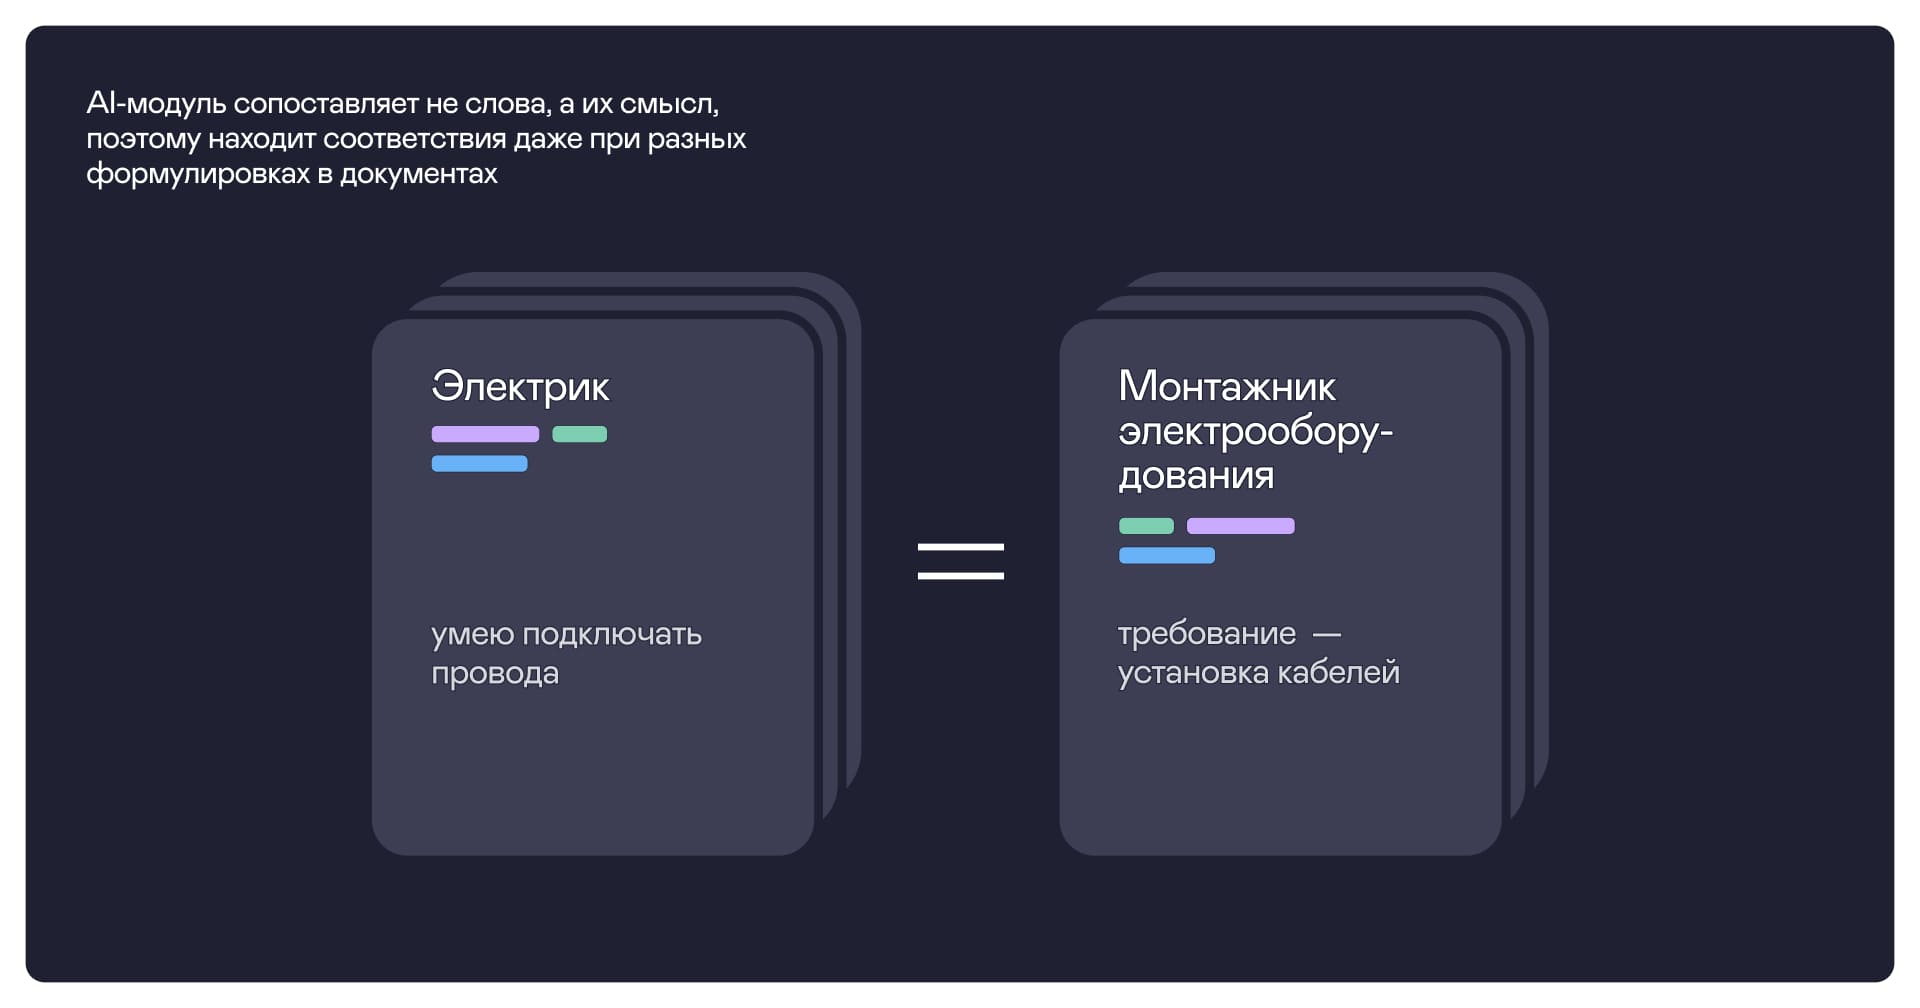
Система анализирует содержание документов и определяет, насколько они близки друг другу по смыслу. Благодаря этому она может находить подходящие материалы, даже когда в текстах используются разные формулировки для одного и того же.
Например, один документ может содержать формулировку «модернизация производственной линии», а другой — «обновление оборудования на предприятии». Обычный поиск может не увидеть связь между ними, а система сопоставит такие документы как близкие по содержанию.
Поиск и ранжирование результатов
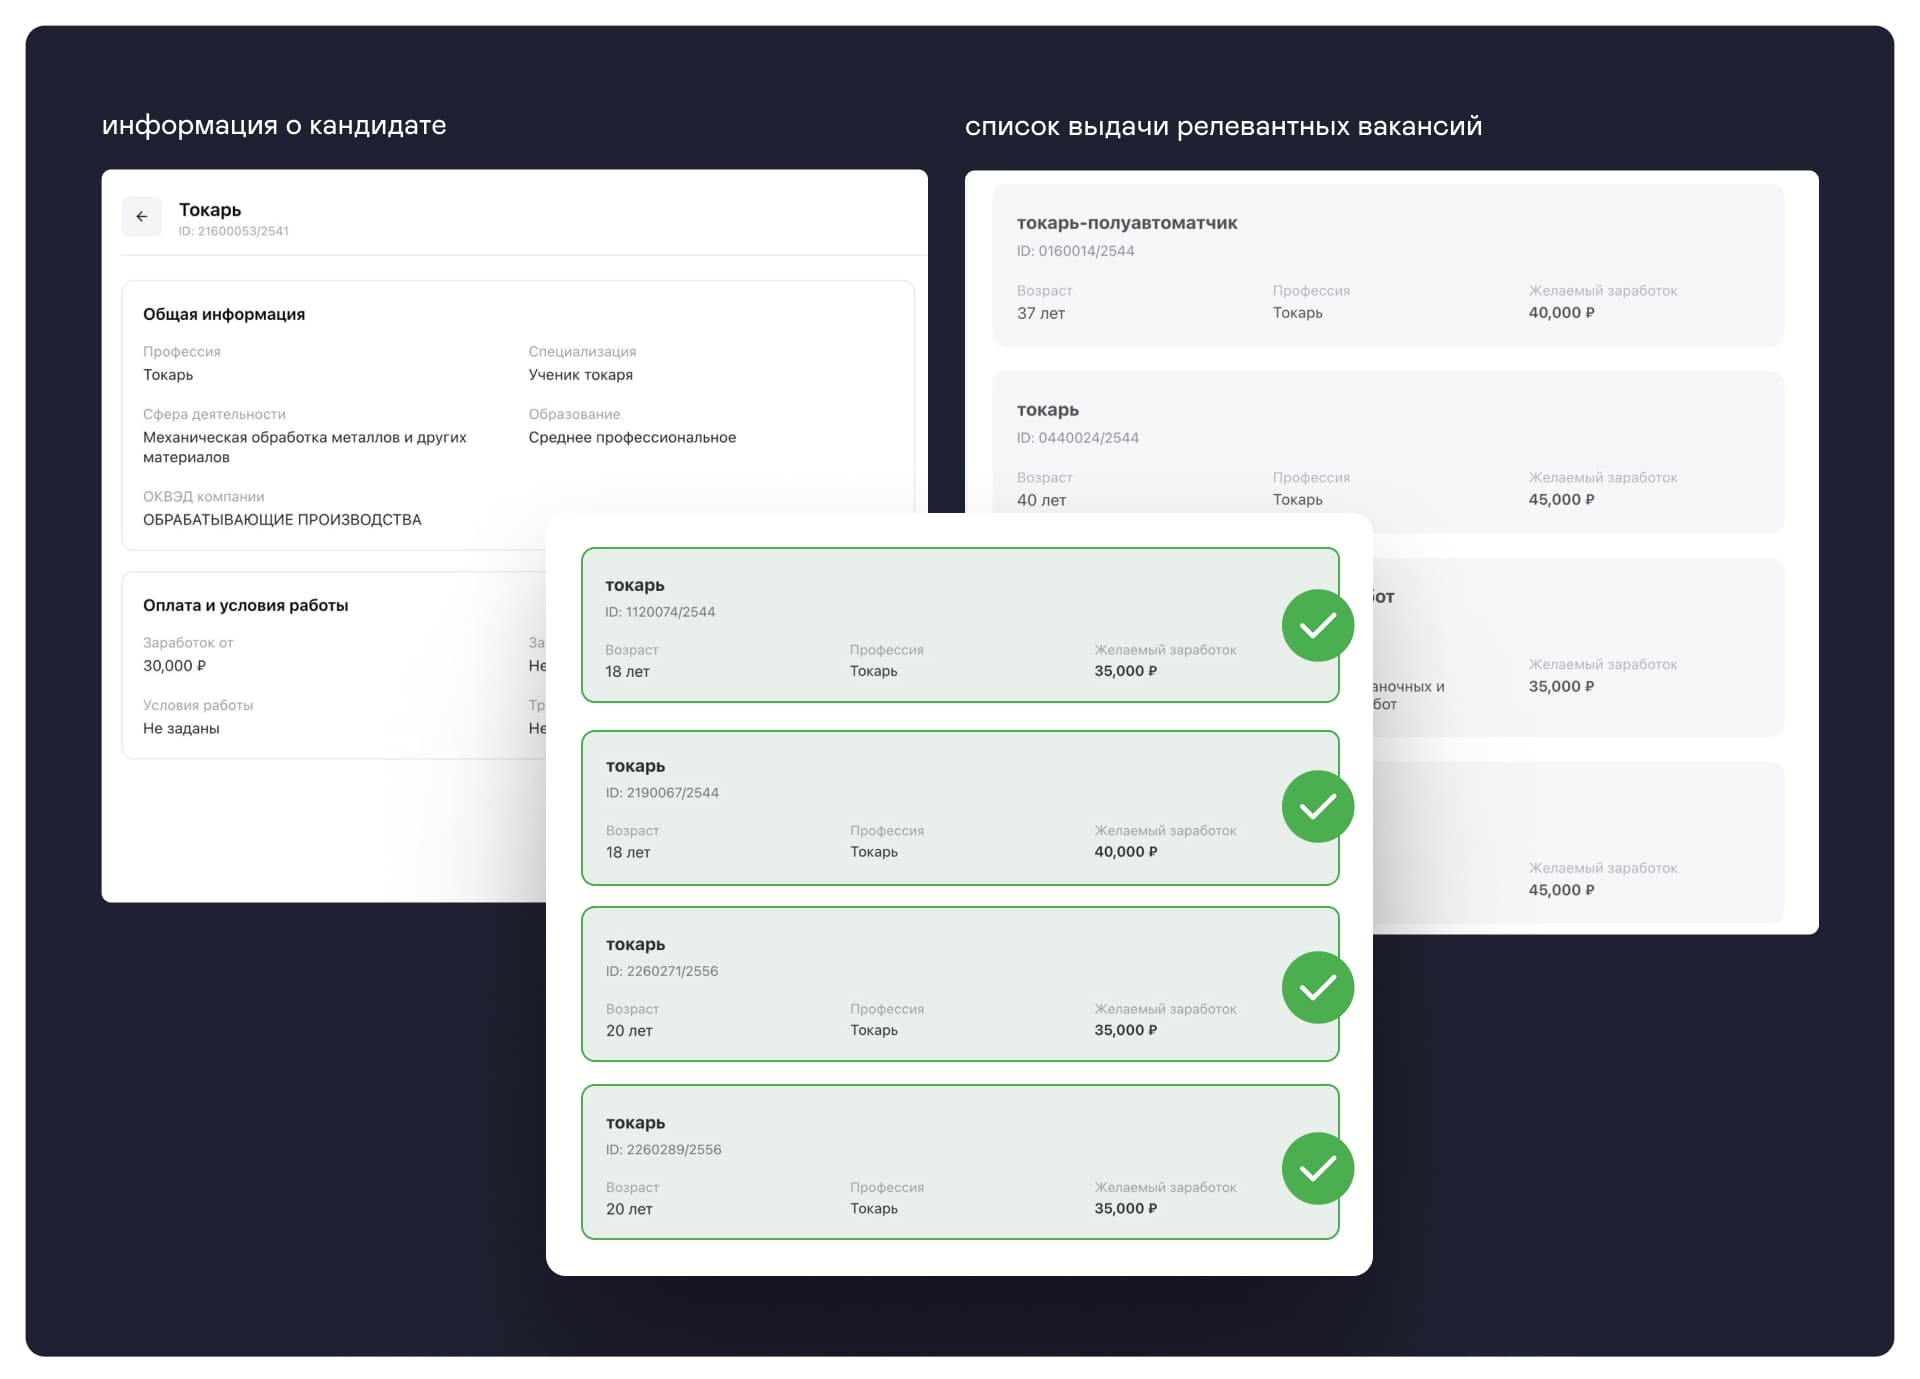
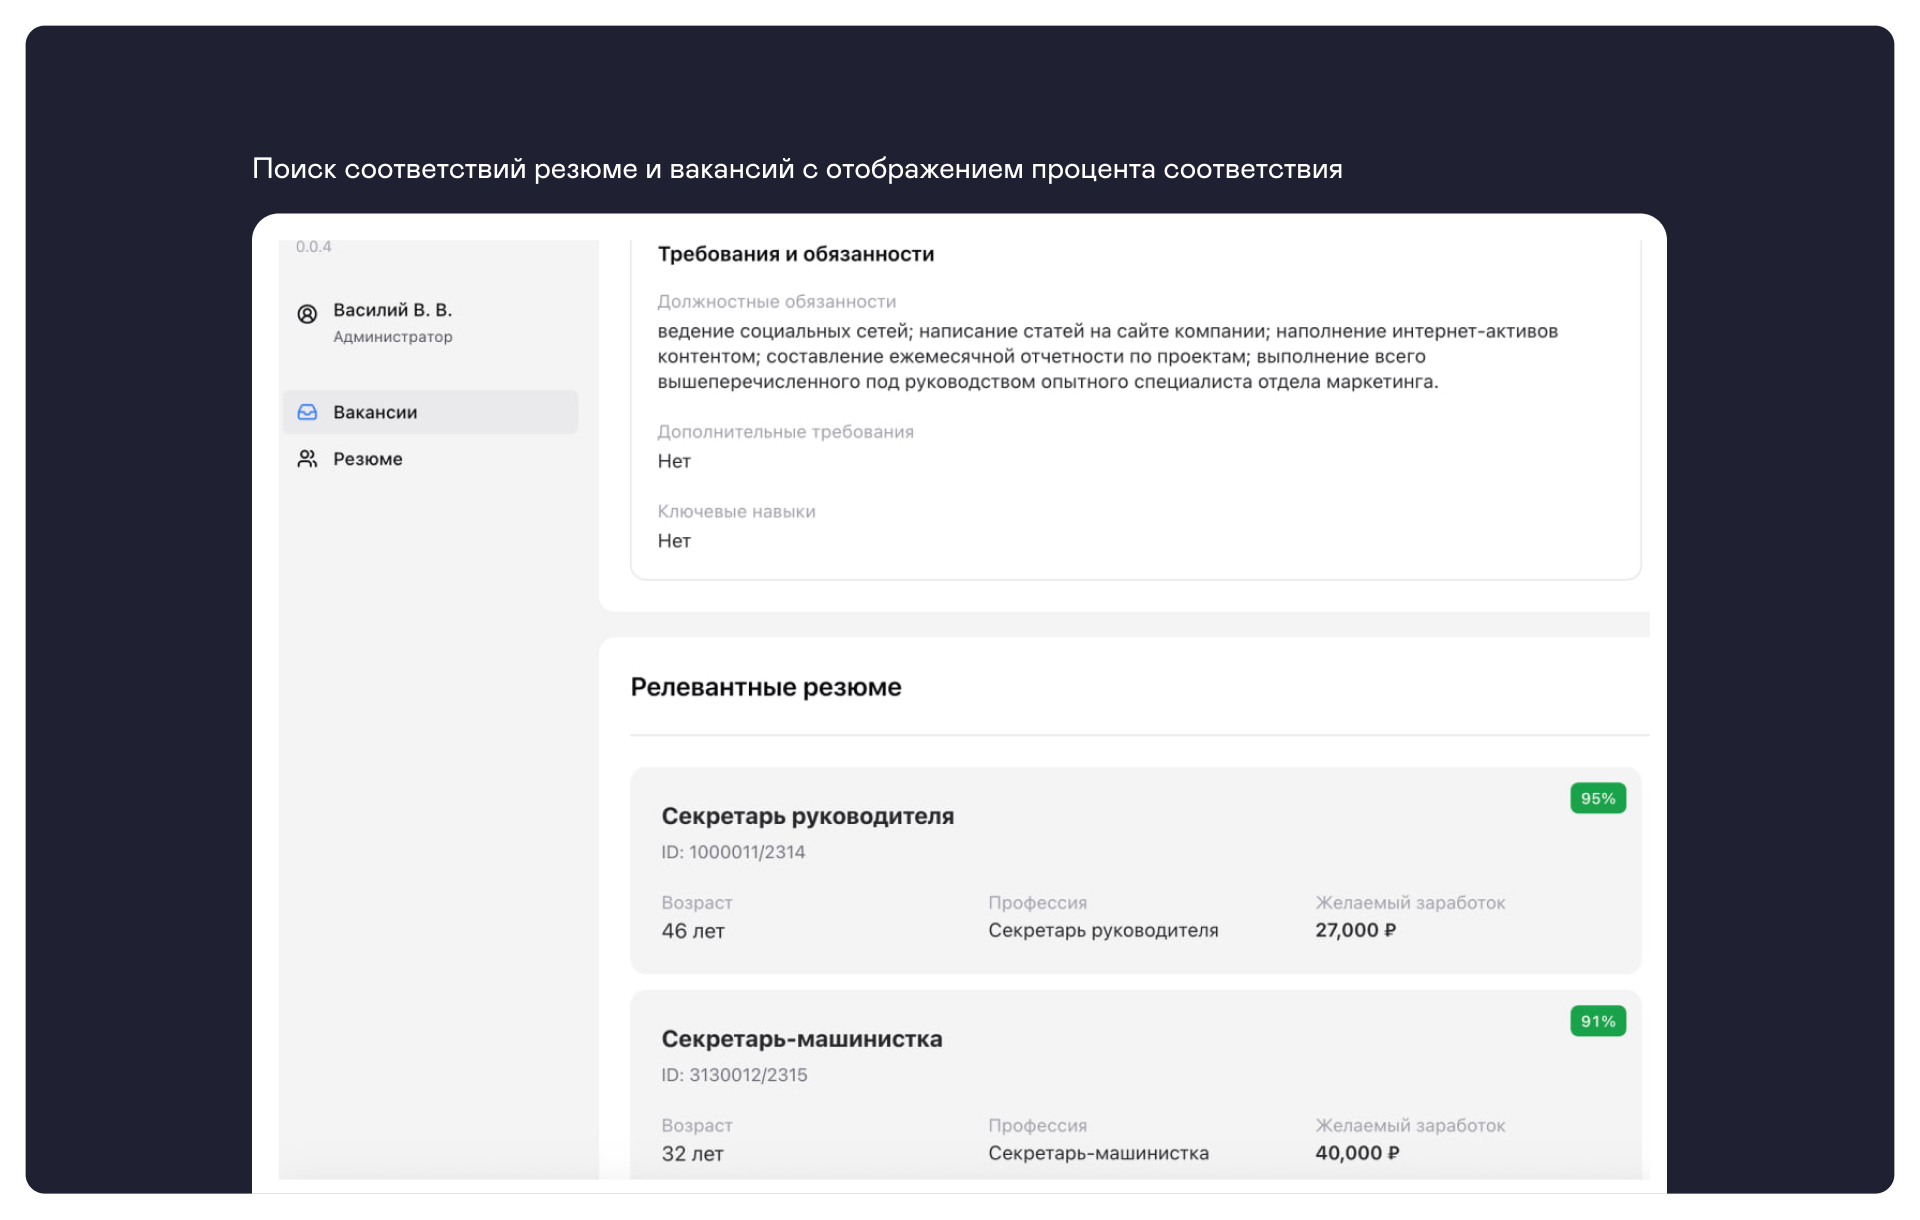
После обработки документа система подбирает подходящие материалы из базы и ранжирует их — выстраивает результаты по убыванию релевантности. Сотрудник получает подборку наиболее подходящих вариантов по убыванию процента соответствия. Это помогает экономить время на просмотре десятков неподходящих записей.
Такой подход можно использовать для подбора кандидатов на вакансии.
Для каждой вакансии он формирует список наиболее подходящих кандидатов, а для каждого соискателя подбирает наиболее релевантные вакансии. При анализе используются и текстовые описания, и структурированные данные — профессия, образование, стаж, квалификация. Система преобразует документы в векторные представления, отражающие их смысловое содержание, после чего рассчитывает степень близости между ними и формирует рейтинг наиболее подходящих результатов.
Развертывание и эффект для бизнеса
Система разворачивается внутри инфраструктуры компании, поэтому данные не передаются сторонним сервисам и остаются внутри корпоративного контура.
Если сотрудник тратит на поиск соответствий около 15 минут, система справляется примерно за минуту. В результате время на выполнение таких задач сокращается на 50–80%.
Даже небольшая ежедневная экономия времени масштабируется на уровне компании. Например, для организации со штатом 100 человек сокращение таких операций всего на 20 минут в день дает более 8 000 высвобожденных рабочих часов в год.
Письмо автору кейса
 Канал в MAX
 Канал в TG
